Jev · 只做选择Jev only chooses
从 AlphaGo 到 Jev 的那块直觉The intuition from AlphaGo to Jev
十年前,AlphaGo 给棋盘上每个空点一个概率。十年后,Jev 也给你列的每个选项一个概率,这块直觉不再只属于一盘棋。Ten years ago AlphaGo gave every empty point on the board a probability. Now Jev gives one to every option you list, and that intuition no longer belongs to a single game.
Full text · in Chinese
十年前,AlphaGo 看一眼棋盘,会在每个空着的交叉点上标一个数:这一手下在这里的可能性有多大。
十年后,我在一个叫 Jev 的模型身上又看到了同样的东西:给它几个选项,它给每个选项一个概率。
一、一个眼熟的输出
2026 年 9 月,一家叫 TypeSafe 的公司发布了 Jev。发布博文里有一个让它玩 Doom 的演示:程序把游戏局面写成文字交给它,问它下一步该怎么走。
看到这个演示,我想起了深度强化学习刚兴起时的两个经典算法模型。
一个是 DQN,2015 年发表在《自然》上:只看画面和分数,在 49 款雅达利游戏上的整体成绩接近职业测试员的水平。它每次看最近几帧画面,给手柄上每个可按的键算一个分,叫 Q 值,大意是“现在按这个键,往后大概还能得多少分”。大多数时候,它按下分数最高的那个。
另一个是 AlphaGo。它的 policy network 读取一张 19×19 的棋盘,给每个落点一个概率。policy 中文常译作“策略”,意思就是“在这个局面下,选每个动作的概率各是多少”。
Jev 在 Doom 里做的是同一件事:看一眼局面,给每个能选的动作一个数。可是 DQN 每学一款游戏,都要单独训练一个网络;AlphaGo 只会下围棋。而 Jev 读的是用自然语言写成的局面和候选,相当于一套通用接口,在请求里就能写出 Doom 的状态和动作空间。
二、AlphaGo 的三件事
AlphaGo 把深度神经网络、强化学习和树搜索结合在了一起,做出了第一个不让子打败职业棋手的围棋程序。在我看来,AlphaGo 是那个时代强化学习的集大成者。拆开看,它做了三件事。
第一件,出一个判断。policy network 读一张 19×19 的棋盘,给 361 个点各一个概率,意思是这一手下在这里的可能性有多大。网络最后一层,每个点对应一个输出,能选的动作在训练之前就定好了;换一个游戏,这一层就得重做。
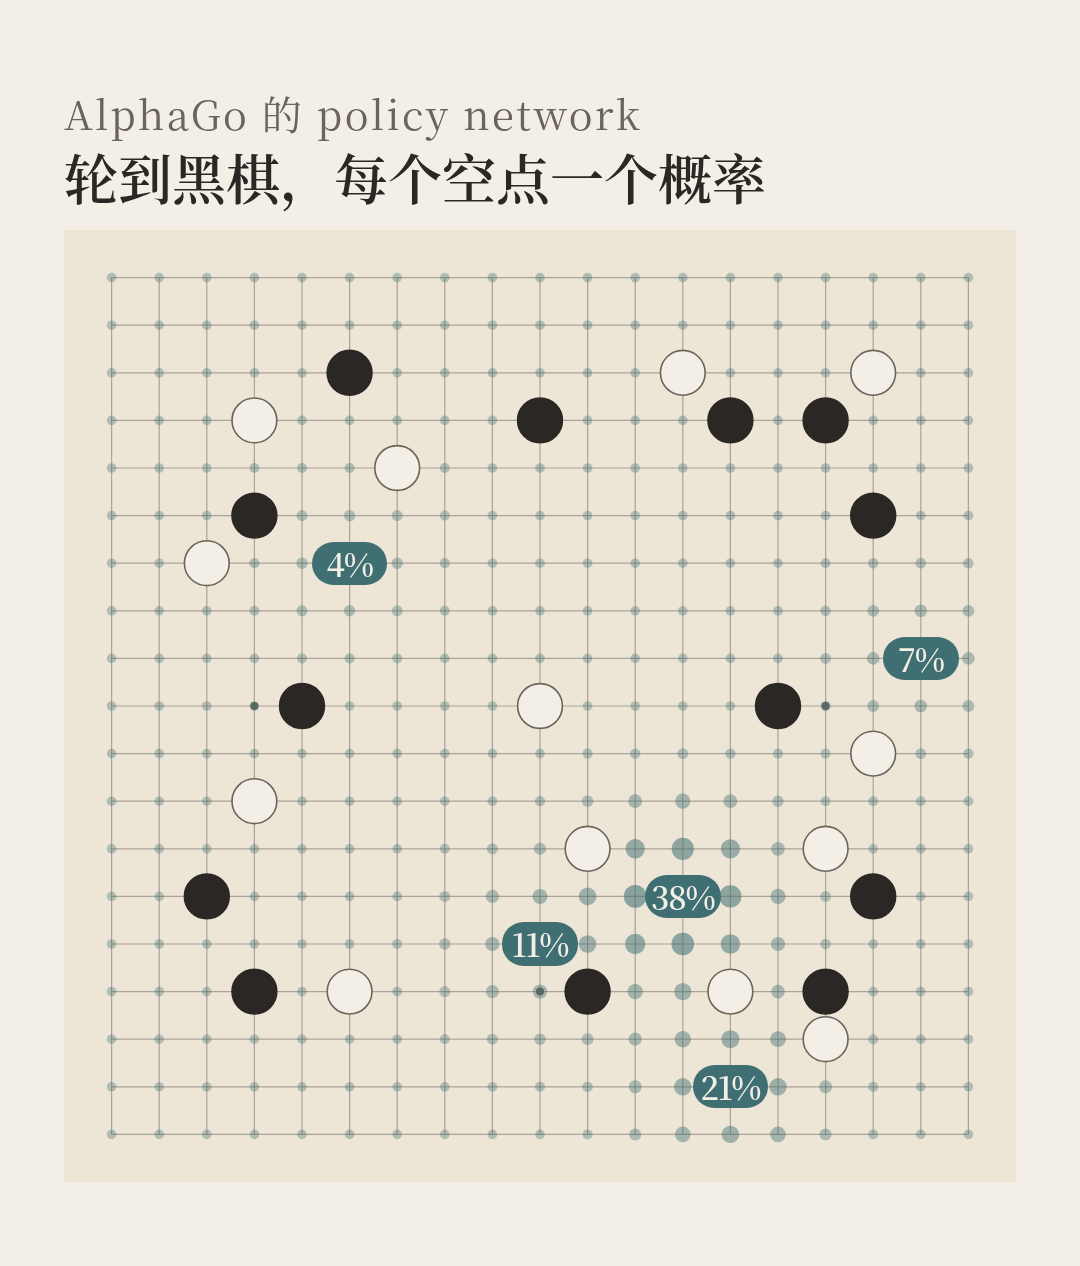
第二件,把判断变成落子。这是比赛时的事,policy network 自己并不拍板。一个叫 APV-MCTS 的搜索把它和一个估胜算的 value network 接在一起:policy 的概率决定先看哪几步,value network 估计走到那里大概有几成胜算,搜索顺着这些走法往下推演很多遍,边推演边修正,最后选被走过次数最多的那一步。用我的类比说,policy 管快速的直觉,搜索管慢慢想。
第三件,从自己的经历里变强。这是训练时的事。AlphaGo 先学着预测人类高手怎么落子,再和自己下,赢了加强这些走法,输了削弱,最终的标准是赢棋。后来的 AlphaGo Zero 连人类棋谱都不要,只从自己和自己下的对局里学习。比赛时用的,就是训练好的那一版。
在我看来,这第三件后来成了一条主线。DeepSeek-R1-Zero 让模型自己解题,主要按答案对不对、外加格式要求来更新模型;agentic RL 让 AI 自己去做一整件事,比如查资料、写代码,再按结果调整模型。我把它们看作同一个思路:让模型在任务上自己跑,用这个任务的结果训练自己。AlphaGo 论文第一作者 David Silver 和强化学习教科书作者之一 Richard Sutton,在 2025 年那篇 Welcome to the Era of Experience 里也把 AlphaZero 和 DeepSeek 都归为“从经验中学习”一类。
三、一个通用的判断模型
AlphaGo 是一整套系统。Jev 不是,它是给别的程序调用的一个判断接口。
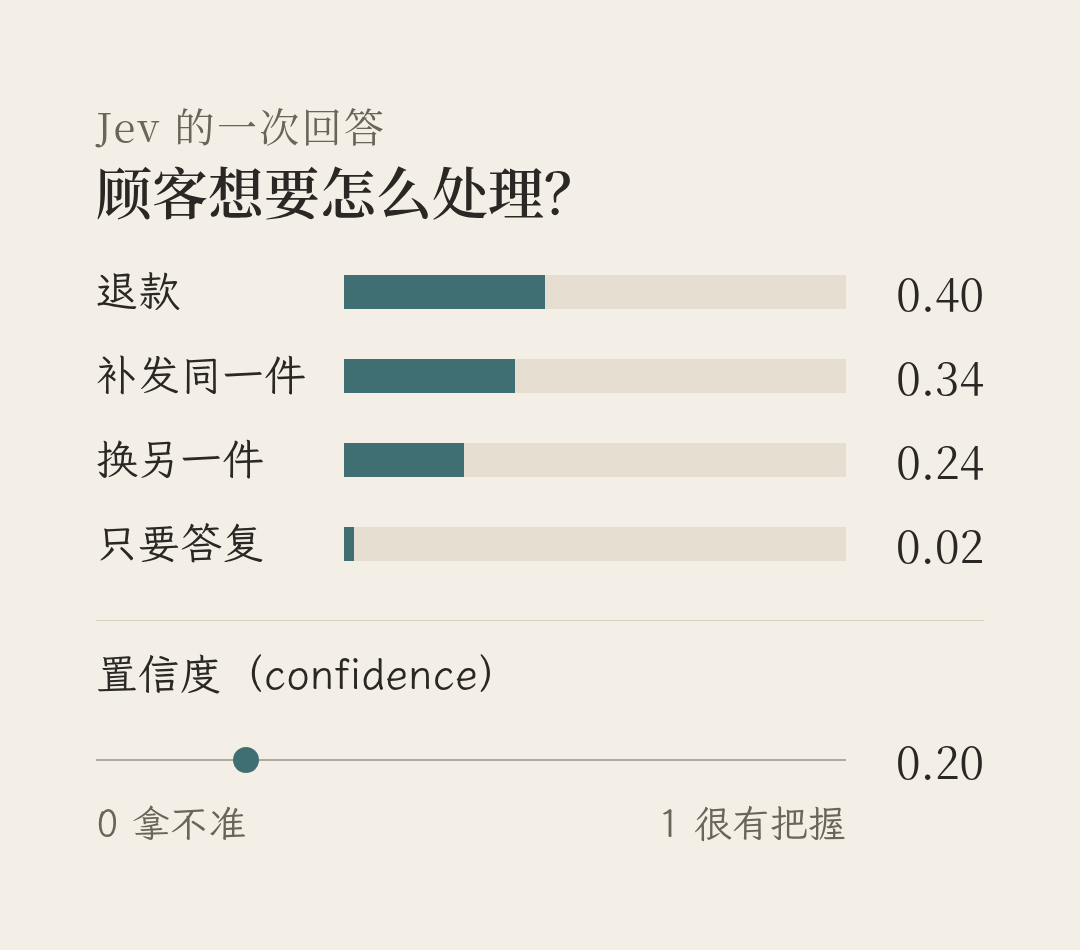
程序把局面写成文字,连同几个候选交给它,它给每个候选一个概率。在 Doom 里,它要选下一步动作;在官方文档的一张客服工单里,它要判断顾客想要什么:鞋晚到、尺码不对、又被重复扣款,顾客却没说想怎么处理,所以下图这组数分得很散。一个是选动作,一个是分类,交回来的都是一组概率。
把候选写进请求,不是 Jev 发明的。2022 年起就有人把大语言模型直接当 policy 用:把能做的动作写进提示词,也就是给模型的说明文字,让它挑一个。
这里有个差别:数是怎么来的。让大模型报一个“0.24”,它是把这个数当文字写出来的,例如拆成 0、点、2、4 几个字块,一个一个挑。Jev 不写字,直接交回一组数。按我的理解,这类数值输出的设计,是直接给每个候选算一个原始分数(logit),再用 softmax 换算成加起来是 1 的概率分布。程序拿到的是结构固定、能直接用的数,用起来更可控。哪种数报得准,仍要拿结果检验;Jev 不同的地方,在于它的训练目标。
它的训练方法叫 RLCD,全称 Reinforcement Learning for Calibrated Decisions,意思是“面向校准决策的强化学习”。按官方的说法,训练目标是让它不止答对,还要让报出的概率和实际准确率对得上:它说有七成把握的那批题,事后大约七成真的答对。这叫校准。官方博文把它和另外两条训练路线放在一起比:RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)让模型学写人类评分员喜欢的回答,ChatGPT 的前身 InstructGPT 就是这么训练出来的;RLVR(Reinforcement Learning with Verifiable Rewards,基于可验证奖励的强化学习)让模型做能被程序自动判对错的题。
回到 AlphaGo 的第三件。AlphaGo Zero、R1-Zero 那条线,依据的是某一个任务的结果:下棋看输赢,解题看答案对不对。Jev 的训练同样叫强化学习,官方说它的概率也是对照真实结果来优化的;不同之处在于目标,它要在各种判断上把概率报准。
校准能当训练目标,是因为统计学里有一类打分方法:模型每报一个概率,事后按结果算分,只有如实报,长期得分才最高。拿这个得分当奖励,就能用强化学习训练一个概率报得准的模型。开源项目 Laya 的作者说自己是这样复现的:报出的那组概率就是模型的动作。RLHF 里的动作是写出下一个词,在 Laya 的做法里,动作是报出一组概率。Jev 自己是不是这样训练的,官方没公开。
概率报得准是训练目标,不等于已经做到。一个开源项目的小规模抽样里,把握最高的那一档概率仍然报得偏高;官方也写了,校准不保证某一个答案是对的。
四、把策略接入不同系统
Jev 交回一组概率之后,下一步由调用它的程序来定。工单示例代码的写法是:置信度(confidence)低于 0.5 就不自动处理,转而询问顾客。这是普通的程序判断,不是搜索。什么情况可以退款、怎样算处理好,这些业务规则也写在程序里。官方的说法是:程序掌控流程,模型负责常识判断。它也会错,官方列过数数、比较日期、选项顺序这几类短板,置信度高也不等于一定答对。程序能做的是按置信度分流,把拿不准的交给人。
能接入不同的系统,是因为程序把局面和候选都写成文字,Jev 交回一组能直接用的概率,这相当于一套通用的状态表示。官方的做法是一个模型服务所有人,候选每次请求现写,所以这块判断能在 Doom 里选下一步,在工单里判断顾客想要什么,在程序的岔口上决定把请求交给写死的代码、更强的大模型还是人。最后这种是 TypeSafe 自己推荐的用法,贵的资源只花在真正需要的地方。
在我看来,这套设计原理上也不必只限于文字,只要局面能写成模型读得懂的状态,图像一样能接入。这也是 agentic AI 的方向:用语言把各种接口统一起来,一个模型就能用在很多不同的任务里。
在我看来,Jev 能火,是因为它解决了分类、分流、打分这些传统问题:以前用大模型也能拼出来,只是不够快,也不够准。任务专属的那部分留在程序里,不用再训练模型;想让它在自己的任务上用得更好,改的是问法和阈值。官方自测 70 到 500 毫秒的响应时间,加上很低的价格,让程序里很多要判断的岔口都挂得上它。
五、放在系统里的直觉
TypeSafe 把 Jev 这类模型叫 System One,名字取自卡尼曼《思考,快与慢》里那个快速、凭直觉的“系统 1”。在 AlphaGo 里,快的直觉旁边有一个慢的搜索;在 Jev 旁边,是你的程序。两边的直觉都不单独拍板,它们的价值要靠旁边那套系统放大。
AlphaGo 的论文里有个发现:放进搜索里,学人类棋谱的那个较弱的 policy,反而比自我对弈训练出来的更强的那个好用。一个部件好不好用,要看它在系统里起什么作用,不只看它单独有多强。
Jev 也被这样用过。有第三方研究者把它放进强化学习的训练过程,让它当参考策略、当探索时的裁判,帮另一个模型学习。AlphaGo 的 policy 给搜索当参考,这里的 Jev 给另一个模型的学习当参考;学习的是那个模型,Jev 只提供判断。
因此,Jev 是一个可以放进很多系统的直觉。局面和候选都用文字写,同一块判断就能在不同的任务里反复用。单独拿来用也行,但我认为它的价值要放进系统里才真正体现出来。十年前那块直觉只属于围棋;这一次,它不只属于一盘棋。我期待它成为通往更通用的智能的一块拼图。
延伸阅读
- Mastering the game of Go with deep neural networks and tree search,AlphaGo Nature 论文:https://www.nature.com/articles/nature16961
- Introducing System One Models and Jev,TypeSafe 发布博文:https://typesafe.ai/blog/introducing-system-one-models-and-jev
- TypeSafe 文档 · 模型说明(含语言支持):https://docs.typesafe.ai/models
- Can Jev be Your Q or Policy in Reinforcement Learning?,第三方实验论文:https://arxiv.org/abs/2610.11692
在这里看Find it on